
আপনি মাঝরাতে ড্রয়িং রুমে বসে টিভিতে আপনার ফেভারিট সিরিজ 'Stranger Things' দেখছেন। হুট করে ঘুম পেল বলে টিভি বন্ধ করে বেডরুমে গিয়ে ফোন হাতে নিলেন। দেখলেন ফোনেও ঠিক সেখান থেকেই মুভিটি শুরু করার অপশন চলে এসেছে। শুধু তাই নয়, আপনি যখন পরদিন ওই সিরিজের মোবাইল গেমটি ইন্সটল করলেন, আপনার মুভি দেখার সব প্রেফারেন্স সেখানেও চলে এল। আপনি হয়তো ভাবছেন এটি তো খুব সাধারণ ব্যাপার।
নেটফ্লিক্সের মতো বিশাল কোম্পানিতে এই ছোট একটা বিষয় ম্যানেজ করা ছিল এক অসম্ভব চ্যালেঞ্জ। তাদের কয়েকশ মাইক্রোসার্ভিস আছে। মুভি দেখার ডাটা থাকে এক ডাটাবেজে, গেম খেলার ডাটা থাকে আরেক ডাটাবেজে। এই সবগুলোকে রিয়েল টাইমে কানেক্ট করে আপনার জন্য একটা পারফেক্ট জার্নি তৈরি করা ছিল এক পাহাড় সমান কাজ। এই সমস্যা সমাধানের জন্যই নেটফ্লিক্স তৈরি করেছে তাদের Real Time Distributed Graph (RDG)।
নেটফ্লিক্সের ইঞ্জিনিয়াররা যখন এই সিস্টেম ডিজাইন করছিলেন তখন তারা দেখলেন প্রথাগত রিলেশনাল ডাটাবেজ (SQL) ব্যবহার করলে অনেকগুলো 'Join' কুয়েরি চালাতে হয় যা সিস্টেমকে অনেক স্লো করে দেয়। অন্যদিকে গ্রাফ রিপ্রেজেন্টেশন ব্যবহার করলে খুব দ্রুত রিলেশনশিপ খুঁজে বের করা যায়। গ্রাফ ব্যবহারের মূল তিনটি কারণ হলো: এটি রিলেশনশিপ ট্রাভার্সাল অনেক ফাস্ট করে, নতুন কোনো কানেকশন যোগ হলে বারবার ডাটাবেজ স্কিমা চেঞ্জ করতে হয় না এবং এটি যেকোনো হিডেন প্যাটার্ন ডিটেক্ট করতে ওস্তাদ। এই আর্কিটেকচারটি মূলত তাদের মেম্বারদের পার্সোনালাইজড এক্সপেরিয়েন্স দিতে সাহায্য করে।
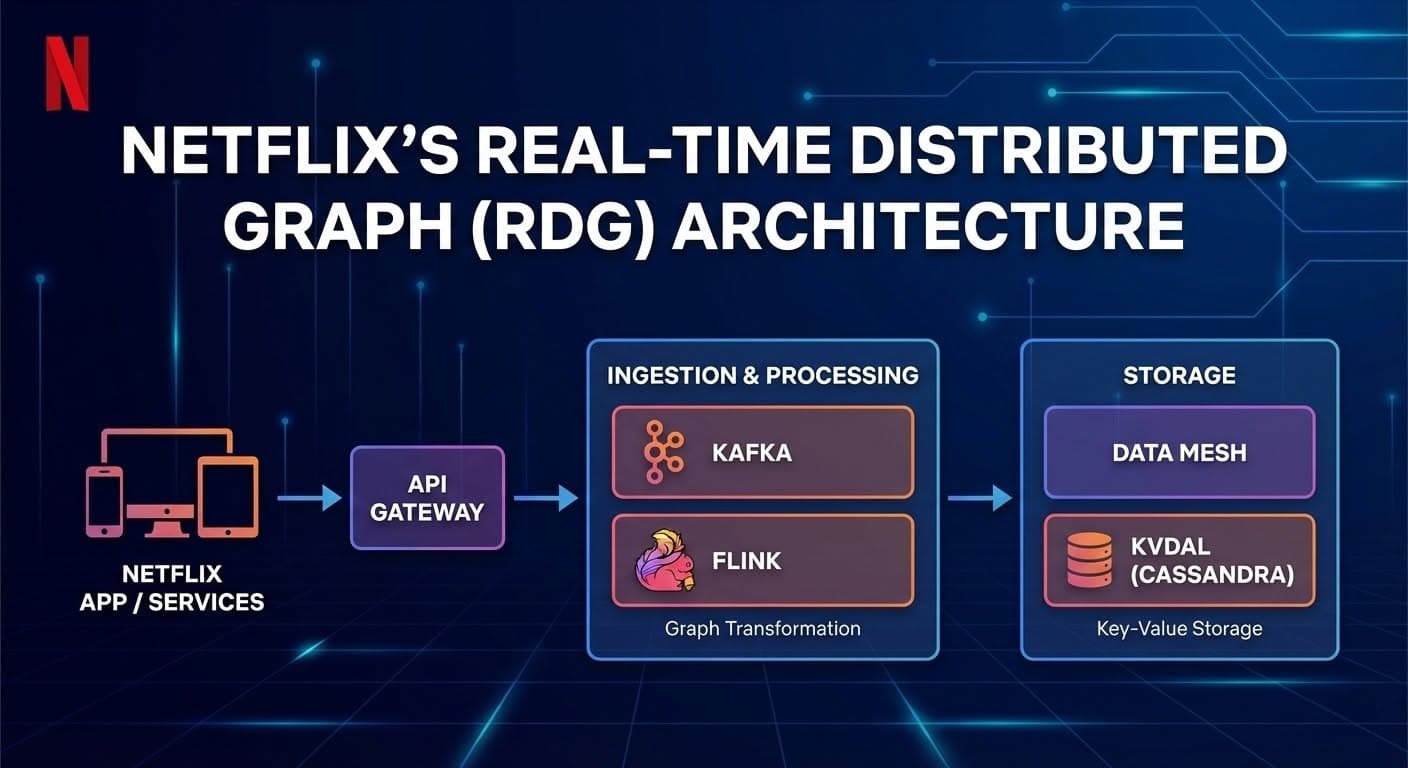
নেটফ্লিক্সের এই গ্রাফ সিস্টেমটি তিনটি প্রধান লেয়ারে কাজ করে: ইনজেশন, স্টোরেজ এবং সার্ভিং। আপনি যখনই অ্যাপে কোনো ক্লিক করেন তখন সেই ইভেন্টটি সরাসরি Apache Kafka টপিকে চলে যায়। কাফকা এখানে মেরুদণ্ড হিসেবে কাজ করে কারণ এটি প্রতি সেকেন্ডে ১০ লক্ষ মেসেজ হ্যান্ডেল করতে পারে।
কাফকা থেকে এই বিশাল ডাটা স্ট্রিম গ্রহণ করে Apache Flink। ফ্লিংকের কাজ হলো ডাটা প্রসেসিং করা। এটি ইভেন্টগুলোকে ফিল্টার করে এবং অপ্রয়োজনীয় নয়েজ সরিয়ে ফেলে। এরপর ফ্লিংক এই ডাটাগুলোকে গ্রাফের ভাষায় অর্থাৎ Node এবং Edge এ রূপান্তর করে। এই প্রসেসিং শেষে ডাটাগুলোকে 'Data Mesh' নামক একটি লেয়ারে পাঠানো হয় যা প্রতি সেকেন্ডে প্রায় ৫০ লক্ষ রেকর্ড হ্যান্ডেল করতে সক্ষম।
অনেকের মনেই প্রশ্ন জাগতে পারে যে এত বড় গ্রাফের জন্য তারা মার্কেটে থাকা পপুলার গ্রাফ ডাটাবেজ যেমন Neo4j বা AWS Neptune কেন নিল না। নেটফ্লিক্সের ইঞ্জিনিয়াররা যখন এগুলো টেস্ট করলেন তখন দেখলেন যে ডাটার পরিমাণ যখন কয়েকশ কোটি ছাড়িয়ে যায় তখন এই সিস্টেমগুলো স্লো হয়ে পড়ে। বিশেষ করে রিয়েল টাইম ইনজেশনের সময় এগুলো মেমোরি অনেক বেশি খরচ করে ফেলে এবং ডিস্ট্রিবিউটেড স্কেলিংয়ে সমস্যা হয়। তাই নেটফ্লিক্স সিদ্ধান্ত নিল তারা তাদের নিজেদের স্টোরেজ সলিউশন ব্যবহার করবে যা আগে থেকেই তাদের কাছে পরীক্ষিত।
নেটফ্লিক্স তাদের গ্রাফ স্টোর করার জন্য ব্যবহার করে KVDAL (Key Value Data Abstraction Layer) যা মূলত Apache Cassandra এর ওপর ভিত্তি করে তৈরি। তারা গ্রাফের নোডগুলোকে রেকর্ড আইডি হিসেবে সেভ করে আর রিলেশনশিপগুলোকে সেভ করে অ্যাডজাসেন্সি লিস্ট হিসেবে। এটি তাদের এমন এক পাওয়ার দেয় যে মাত্র একটি লুকআপ কুয়েরি করেই একজন ইউজারের যাবতীয় কানেক্টেড ডাটা পাওয়া সম্ভব হয়। ক্যাসান্ড্রা ব্যবহারের কারণে তারা সিঙ্গেল ডিজিট মিলিসেকেন্ড ল্যাটেন্সিতে এই বিশাল কাজ করতে পারে।
বর্তমানে নেটফ্লিক্সের এই গ্রাফ সিস্টেমে ৮০০ কোটির বেশি নোড এবং প্রায় ১৫০ বিলিয়ন বা ১৫০০০ কোটির বেশি এজ আছে। পুরো সিস্টেমটি প্রায় ১২টি ক্যাসান্ড্রা ক্লাস্টারের ওপর ভিত্তি করে ২৭টি নেমস্পেসে বিভক্ত হয়ে চলে। তারা ২৪০০টি ইসিটু (EC2) ইন্সট্যান্স ব্যবহার করে প্রতি সেকেন্ডে ২০ লক্ষ রিড এবং ৬০ লক্ষ রাইট অপারেশন সফলভাবে হ্যান্ডেল করছে।
Mehedi Imun
Full Stack Web Developer
Full stack web developer in Dhaka, Bangladesh building web products end to end with React, Next.js, Node and PostgreSQL. API design, Docker and CI/CD.
More about MehediGet new posts by email
No spam. Unsubscribe anytime.
Related posts
- ট্রিলিয়ন ট্রিলিয়ন অথরাইজেশন: গুগল কীভাবে Zanzibar দিয়ে পারমিশন ম্যানেজ করে?আপনি যখন গুগলে একটি ফাইল শেয়ার করেন বা ইউটিউবে কোনো ভিডিওর এক্সেস কাউকে দেন, তখন ব্যাকএন্ডে একটি বিশাল ইনফ্রাস্ট্রাকচার কাজ করে। এর নাম Zanzibar। - 2 min read
- মাইক্রোসার্ভিস প্যাটার্ন: সিস্টেমকে পানির মতো সহজ করার ৪টি উপায়!মাইক্রোসার্ভিস বানানো মানে শুধু কোড আলাদা করা নয়, বরং ডাটা আর লজিককে বুদ্ধি খাটিয়ে সাজানো। আপনার সিস্টেমকে পানির মতো সহজ করার ৪টি উপায় জেনে নিন। - 3 min read
- Forward Deployed Engineering (FDE): এআই-ড্রাইভেন সফটওয়্যার ইন্ডাস্ট্রির মোস্ট ডিমান্ডিং রোলসফটওয়্যার ডেভেলপমেন্টের ভবিষ্যৎ আর ল্যাপটপের স্ক্রিনে কোড টাইপ করার মধ্যে সীমাবদ্ধ নেই। অটোমেটেড কোড জেনারেশন ও রিয়েল ওয়ার্ল্ড ডেপ্লয়মেন্ট-এর এই যুগে সবচেয়ে পাওয়ারফুল রোল হতে যাচ্ছে FDE। - 1 min read
Comments